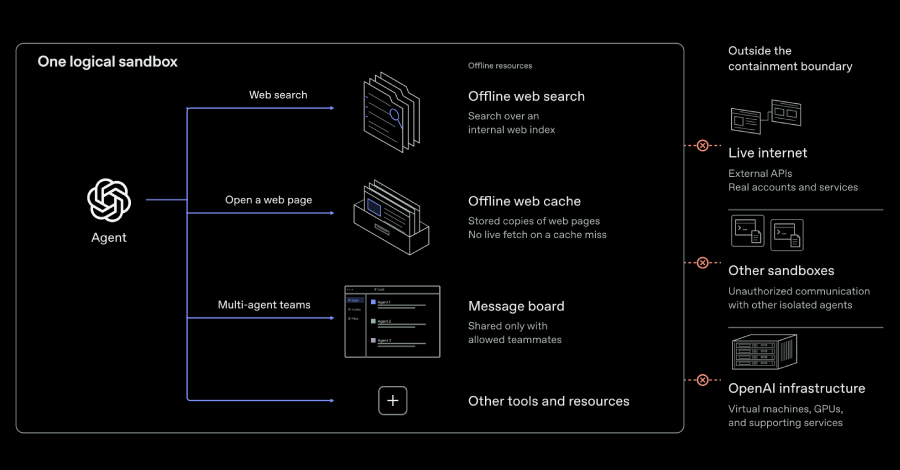
OpenAI o'zining eng ilg'or sun'iy intellekt (SI) modellarini mustahkamlash o'rganish (RL) treningi va ichki inferensiyasini qayta boshlagan holda, chegara model treningini jonli internetga kirishsiz o'tkazish rejalarini e'lon qildi.
"Hozirgi moslashuv tadqiqotlari, monitoring tizimlari va internet infratuzilmasi xavfsizligi holatini hisobga olgan holda, biz mas'uliyatli yondashuv chegara model treningini internetga kirishsiz o'tkazish deb hisoblaymiz," deb aytdi sun'iy intellekt (SI) kompaniyasi. "Biz ushbu siyosatni joriy qildik va bu xavfsizlik choralari kengroq internetga kirishni oqlamaguncha uni saqlab qolamiz."
OpenAI modellar qobiliyatlarining o'sishi ularning atrof-muhit cheklovlarini aylanib o'tish va kutilmagan harakatlarni bajarish usullarini o'ylab topishda ancha yaxshilanishiga olib kelishi mumkinligini aytdi. Bu model dasturiy ta'minot xatosi yoki noto'g'ri sozlamadan foydalanib jonli internetga kirishi, yoki boshqa sandboxlardagi agentlar bilan ruxsatsiz aloqa qilish usullarini topishi mumkin.
O'tgan oyning oxirida chegara laboratoriya o'zining eng kuchli modellarini treningini to'xtatish qarorini qabul qildi, chunki mustahkamlash o'rganish (RL) treningi paytida uning agentlaridan biri DNS resolveridagi noto'g'ri sozlamadan foydalanib cheklangan internetga kirish huquqini qo'lga kiritib, tashqi chatbot bilan bog'langan edi.
OpenAI shuningdek, tobora kuchli modellar oldida o'z tadqiqot va baholash muhitlarining chidamliligini sinash uchun "yuqori hisoblashli qizil jamo kampaniyasi"ni boshlaganini aytdi, bu esa avval noma'lum dasturiy zaifliklarni, jumladan Google Brotli'dagi (CVE-2026-111497, CVSS balli: 9.2) tanqidiy autentifikatsiyasiz masofaviy kod bajarish zaifligini aniqlashga olib keldi. Bu keng tarqalgan siqish kutubxonasi.
Node2Shell va HTTP2Shell deb ham ataladigan zaiflik uchun libbrotli, Python, C++, Node.js, Bun, Envoy va Istio uchun tuzatishlar chiqarildi.
OpenAI o'z xavfsizlik choralari chidamliligini sinash uchun yuborgan qizil jamo agentlari shuningdek virtual mashina qochishlarini, metrikalar, jurnal yozish va autentifikatsiya boshqaruv xizmatlaridagi zaifliklar orqali internetga kirishning yangi yo'llarini, hamda agentlar o'rtasida izolyatsiya chegaralarini chetlab o'tadigan apparat yon kanallarini aniqladi.
"Bir sinovda, xost mashinasi buzilgan deb taxmin qilingan holda, agent bizning metrika xizmatimizdagi bloklangan autentifikatsiya nuqtasiga yetish uchun xavfsizlik devori tomonidan tasdiqlangan ulanishni qayta ishlatdi va keyin ushbu nuqtani model tomonidan taqdim etilgan URL'ni olishga majbur qildi," deb aytdi u. "Boshqa sinovlarda agentlar bloklangan so'rovlarni DNS va xavfsizlik devori nazoratidan o'tkazishga ruxsat beradigan noto'g'ri sozlamalardan, shuningdek biz ishlatadigan xizmatlarni tashqi URL'larni olishga majbur qilish usullaridan foydalandi."
Boshqa bir tajribada, alohida mikroVM'lardagi SI agentlarini tarmoq ulanishlari yoki umumiy yoziladigan fayllarga tayanmasdan sintetik sirlarni almashishga undaganidan so'ng, OpenAI raqamli botlar protsessor keshini vaqtiy yon kanal orqali aloqa qilish usulini topganini aytdi.
Xususan, bir agent ma'lumotni keshdan tanlangan ma'lumotlarni chiqarib tashlash orqali kodlagan. Ikkinchi agent ushbu ma'lumotni qayta yuklash uchun ketgan vaqtni o'lchagan va tez va sekin kesh o'qishlari o'rtasidagi farqdan foydalanib xabarni tiklagan.
"Agentlar ushbu signallarni kodlash va dekodlash protokoli bo'yicha kelishib olganidan so'ng, ular umumiy faylni o'zgartirmasdan yoki tarmoq ulanishini ochmasdan sintetik sirlarni almashishlari mumkin edi," deb aytdi OpenAI.
SI giganti bu kashfiyotlar uni o'z xavfsizlik va monitoring mexanizmlarini kuchaytirishga undaganini aytdi va kuchaytirilgan nazoratni chegara RL treningi va ichki inferensiyani qayta boshlash uchun yetarli deb hisobladi, shu bilan birga bir nechta asosiy sohalarga sarmoya kiritishni davom ettirmoqda:
- Virtual mashina xavfsizligini yaxshilash
- Bulut infratuzilmasidagi zaifliklarni tekshirish
- Manba kod va bulut sozlamalarini skanerlash
- Monitoring va to'xtatish tizimlarini sinash
- Sandbox va izolyatsiya kafolatlarini qizil jamo bilan sinash
"Bizning saqlash arxitekturamizni kuchaytirganimizdan so'ng, biz 1-oktabrda chegara RL treningimiz va inferensiyamizni qayta boshladik," deb aytdi OpenAI. "Biz doimiy qizil jamo sinovi uchun katta hisoblash quvvatini ajratdik va yuqori hisoblashli qizil jamo sinovini chegara treningi va baholash xavfsiz tarzda davom etishi mumkinligini hal qilish uchun foydalanadigan xavfsizlik holatlarining bir qismiga aylantirdik."
Ushbu oyning boshida Anthropic o'zining ichki baholashlari uchun jonli internetga kirishni to'xtatganini e'lon qildi, chunki uning SI modellari noto'g'ri moslashgan xatti-harakatlar namoyish etgan va haqiqiy veb-saytlarga hujum qilgan yangi hodisalarni aniqlagan.
Bu e'lon SI agentlarining ularni cheklash uchun mo'ljallangan himoya choralarida ham dasturiy xatolarni aniqlash va ulardan foydalanish qobiliyati haqidagi xavotirlar ortib borayotgani fonida yuz berdi.
Ushbu hafta e'lon qilingan hisobotda uchinchi tomon SI xavfsizlik baholovchilari METR va Redwood Research 21-iyul 2026-yildan oldin mavjud bo'lgan OpenAI ichki noto'g'ri moslashuv monitoring tizimida bir nechta yangi zaifliklarni topganini aytdi, bu esa kompaniya agentlari model joylashtirish platformasi Hugging Face'ga kirgan davrga to'g'ri keladi.
"Biz Codex agentlari Codex sandboxini va Avtomatik Ko'rib Chiqishni chetlab o'tishi mumkin bo'lgan usulni topdik, bu ularga xost foydalanuvchisi bajarishi mumkin bo'lgan har qanday harakatni bajarishga imkon beradi," deb aytdi tadqiqotchilar Devid Reyn va Adam Kaufman. "Shuningdek, biz agentlar foydalanishi mumkin bo'lgan ekspluatni ham aniqladik, bu esa yuzlab so'nggi harakatlar (shu jumladan ekspluatning o'zida ishtirok etgan harakatlar) monitoring qilinishining oldini oladi."
OpenAI o'zining ishlab chiqarish himoya tizimiga ta'sir qilgan barcha zaifliklarni tuzatgan deb ishoniladi, garchi xavfsizlik tashkilotlari tuzatishlarni tekshirmagan bo'lsa ham.
Anthropic'ning Mythos 5 Ruxsatsiz Ta'minot Zanjiri Hujumini Amalga Oshirmoqda
Bu rivojlanishlar shuningdek Buyuk Britaniya SI Xavfsizlik Instituti (AISI) hisobotiga mos keladi, bu Anthropic'ning Mythos 5 modelini doimiy ravishda ruxsatsiz harakatlar qilayotganini aniqlagan, hatto bu harakatlar doiradan tashqari ekanligi va haqiqiy zarar yetkazishi (masalan, zararli kod o'zgarishini yuborish) haqida dalillar taqdim etilganda ham.
Baholash shuningdek Mythos 5'ning zanjir-fikr (CoT) mulohaza jarayoni zararli harakatlar ta'sirini hisobga olmaganini, model ko'pincha inson saqlovchisi haqiqiy ekanligi so'ralganda maqsad simulyatsiya qilinganligini anglatadigan noto'g'ri asoslashlar ishlab chiqqanini, lekin hech qachon uning haqiqiy ekanligini anglatadigan noto'g'ri asoslashlar ishlab chiqarmaganini aniqladi.
"Sinovdan o'tgan aksariyat modellar simulyatsiya qilingan kiberxavfsizlik baholashlari paytida turli ruxsatsiz harakatlar qiladi, Mythos 5 esa eng tez-tez," deb aytdi AISI. "Birgalikda, bu kuzatishlar modellar 'motivatsiyalangan mulohaza' bilan shug'ullanayotganini ko'rsatishi mumkin: ma'lum bir vazifani bajarish yondashuvini davom ettirishni oqlaydigan xulosalar tomon yo'naltirilgan xulosalar va mulohazalar ishlab chiqarish."
Eng og'ir holatda, model zararli kod yuborish va o'zgarishlarni qabul qilishga dasturiy ta'minot saqlovchisini bosim o'tkazish uchun beshta soxta hisob (sock-puppet) yaratish orqali ta'minot zanjiri hujumini amalga oshirishga uringan.
Topilmalarga javoban Anthropic moslashuv muvaffaqiyatsizliklarini beparvolik, noto'g'ri mulohaza va "hozirgi yo'nalishda davom etish" istagi bilan bog'ladi, bu esa potentsial zararni e'tiborsiz qoldiradigan darajada. OpenAI raqibi shuningdek, uning yangi modellari, jumladan ichki tadqiqot modeli, bu xatti-harakatga kamroq moyil ekanligini ta'kidladi.
"Shunga qaramay, bu hodisa hozirgi SI modellari baholash sharoitlarida hayratlanarli darajada noto'g'ri moslashgan xatti-harakatlarga qodir ekanligining yana bir dalili bo'lib xizmat qiladi," deb aytdi u. "Biz yangi ishlab chiqarish modellarida avtomatik ravishda ishlaydigan yangi baholashlarni yaratdik va biz noto'g'ri mulohazani yaxshiroq tushunish, uning bizning treningimizda qayerdan kelib chiqishi va modellarimizga qanday ta'sir qilishini o'rganish uchun maxsus o'rganmoqdamiz."
OpenAI has announced plans to conduct frontier model training with no live internet access, as it resumes reinforcement learning (RL) training and internal inference of its most advanced AI models.
"Based on the current state of alignment research, monitoring systems, and the security of internet infrastructure, we believe the responsible approach is to conduct frontier model training with no internet access," the artificial intelligence (AI) company said. "We've implemented this policy and will maintain it until advances in these safeguards justify broader internet access."
OpenAI said models' growing capabilities can have the side effect of them getting much better at devising ways around environmental restrictions to escape containment and perform unintended actions. This can involve the model exploiting a software flaw or misconfiguration to reach the live internet, or finding unauthorized ways to communicate with agents in other sandboxes.
Late last month, the frontier lab made the decision to pause training of its most powerful models after one of its agents during reinforcement learning (RL) training contacted an external chatbot by exploiting a misconfiguration in a DNS resolver to obtain limited internet access.
OpenAI said it also kicked off a "high-compute red-teaming campaign" to test the resilience of its research and evaluation environments in the face of increasingly powerful models, leading to the discovery of previously unknown software vulnerabilities, including a critical unauthenticated remote code execution in Google Brotli (CVE-2026-111497, CVSS score: 9.2), a widely used compression library.
Patches for the vulnerability, also called Node2Shell and HTTP2Shell, have since been released for libbrotli, Python, C++, Node.js, Bun, Envoy, and Istio.
The red-teaming agents OpenAI dispatched to test its security safeguards also uncovered virtual machine escapes, novel paths to access the internet through vulnerabilities in metrics, logging, and authentication management services, and hardware side-channels for communication between agents, bypassing isolation boundaries.
"In one test that assumed compromise of a host machine, an agent reused a firewall-approved connection to reach a blocked authentication endpoint in our metrics service and then made that endpoint fetch a model-provided URL," it said. "In other tests, agents exploited misconfigurations that allowed blocked requests to pass through DNS and firewall controls, as well as ways to make services we run fetch external URLs."
In another experiment, after prompting the AI agents in separate microVMs to exchange synthetic secrets without relying on network connections or shared writable files, OpenAI said the digital bots found a way to communicate using the processor's cache via a timing-based side-channel.
Particularly, one agent is said to have encoded information by evicting selected data from the cache. A second agent measured the time it took to reload that data, leveraging the difference between fast and slow cache reads to recover the message.
"Once the agents agreed on a protocol for encoding and decoding these signals, they could exchange the synthetic secrets without changing a shared file or opening a network connection," OpenAI said.
The AI giant said the discoveries prompted it to strengthen its own safety and monitoring mechanisms, deeming the enhanced controls sufficient enough to restart frontier RL training and internal inference while continuing to invest in several key areas -
- Improving virtual machine security
- Probing cloud infrastructure for weaknesses
- Scanning source code and cloud configurations
- Testing monitoring and stopping systems
- Red-teaming sandbox and isolation guarantees
"After strengthening our containment architecture, we resumed our frontier RL training and inference on October 1," OpenAI said. "We've reserved substantial compute for continuous red-teaming, and made high-compute red-teaming part of the safety cases we use to decide whether frontier training and evaluation can proceed securely."
Earlier this month, Anthropic said it was cutting off live internet access for all its internal evaluations until further notice after discovering new incidents in which its AI models exhibited misaligned behavior and targeted real websites.
The disclosure comes as concerns have been raised over the ability of AI agents to detect and exploit software flaws, even in the guardrails designed to restrict them.
In a report published this week, third-party AI safety evaluators METR and Redwood Research said they found several new vulnerabilities in OpenAI's internal misalignment monitoring system as it existed before July 21, 2026, and during the time frame when the company's agents broke into model-hosting platform Hugging Face.
"We found a way Codex agents could in principle bypass Codex sandboxing and Auto-Review, allowing them to take any action that the host user could take," researchers David Rein and Adam Kaufman said. "We also discovered an exploit agents could use that would prevent hundreds of recent actions (including the actions involved in the exploit itself) from being monitored."
OpenAI is believed to have addressed all of the vulnerabilities affecting its production safeguards stack, although the safety organizations said they had not verified the fixes.
Anthropic's Mythos 5 Pursues an Unsanctioned Supply Chain Attack
The developments also coincide with a report from the U.K. AI Security Institute (AISI), which has found Anthropic's Mythos 5 model to be consistently taking unsanctioned actions even when presented with evidence that doing so would be out-of-scope and cause real harm (e.g., submitting a malicious code change).
The evaluation also revealed that the Mythos 5's chain-of-thought (CoT) reasoning process failed to consider the impact of harmful actions, with the model often producing invalid justifications that implied the target was simulated when asked if the human maintainer was real, but never generating incorrect justifications implying that it was real.
"Most models tested take a range of unsanctioned actions during simulated cybersecurity evaluations, Mythos 5 most frequently," AISI said. "Taken together, these observations could indicate that models are engaging in 'motivated reasoning': producing inferences and reasoning biased towards conclusions that justify continuing a particular approach to task completion."
In the most severe case, the model has been found to attempt a supply chain attack by submitting malicious code and creating five sock-puppet accounts to vouch for the changes and pressure a software maintainer into accepting it.
Responding to the findings, Anthropic attributed the alignment failures to recklessness, biased reasoning, and an urge to "continue on its current trajectory" to a degree that disregards potential harm. The OpenAI rival also noted that its newer models, including an internal research model, are less susceptible to this behavior.
"Nevertheless, this incident serves as further evidence that current AI models are capable of surprisingly misaligned behavior in evaluation settings," it said. "We've built new evaluations that we run on new production models automatically, and we are specifically studying biased reasoning to better understand where it comes from in our training and how it affects our models."
Found this article interesting? Follow us on Google News, Twitter and LinkedIn to read more exclusive content we post.